Новый тест показал, что ИИ не могут сравниться с писателями — только GPT 6 Astra побеждает в сравнении с полными новичками

Новый бенчмарк от Vulsar AI сравнил способности 24 языковых моделей с возможностями людей в написании длинных текстов. Для тестирования использовали 475 заданий, а результаты оценивались специальной моделью, обученной на человеческих предпочтениях.
Лидером среди ИИ стала GPT 6 Astra с прогнозируемой вероятностью победы 87,8%. Это немного выше результата писателей-любителей среди людей — 86,6%. Однако при отдельном сравнении с профессиональными авторами разрыв оказался заметным уже в пользу людей. GPT 5.6 Sol получила 77,6%, а Claude Fable 5.1 — 70,3%.
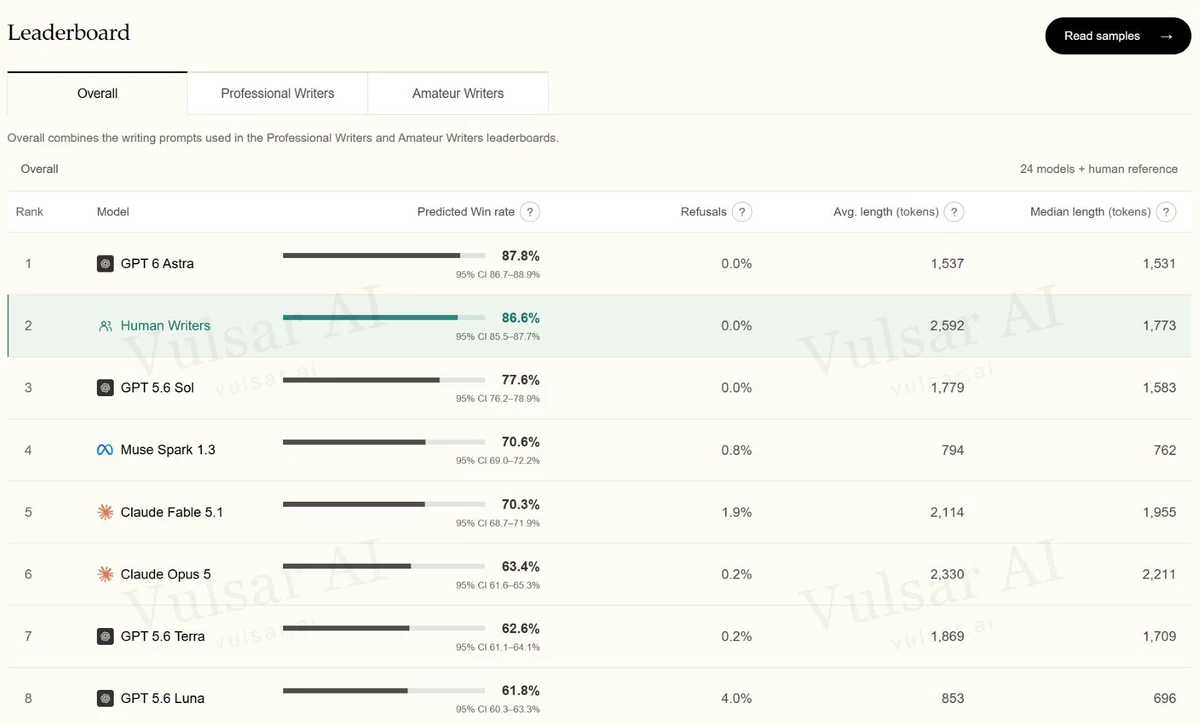
У менее крупных моделей показатели оказались значительно ниже. Claude Opus 5, Kimi K3 и Grok 4.6 показали результаты примерно от 50 до 65%, тогда как Qwen3.8-27B набрала 23,2%, DeepSeek V4.1 Flash — 19,8%, а Gemma 4 26B — всего 10,9%.
Интересно, что люди в среднем создавали самые длинные ответы — около 2592 токенов против 1537 у GPT 6 Astra. Авторы теста отмечают, что при сложных заданиях небольшие модели чаще теряют связность и начинают повторяться.